Die Forschung in den Exercise Sciences steht vor einem grundlegenden methodologischen Problem: Sie untersucht häufig Spitzen- und Weltklasse-Athleten – eine Population, die per Definition keine Grundgesamtheit in statistischem Sinne bildet. Ein Läufer, der die 1500 m in unter 3:30 min absolviert, ist kein zufälliges Sample aus einer normalverteilten Grundgesamtheit. Er ist ein singuläres Phänomen mit ganz individuellen Voraussetzungen und Reaktionen auf Trainingsreize.
McLean et al. (2021) identifizieren in ihrer Systemanalyse der Exercise Sciences grundlegende Probleme: Überbetonung quantitativer Methoden, mangelnde ökologische Validität, einen tiefen Graben zwischen Forschung und Praxis. Methodologische Debatten wie jene um Magnitude-Based Inference (Lohse et al. 2020) zeigen, dass das Feld selbst nach besseren Wegen sucht. Bayesianische Statistik ist nicht nur eine technische Alternative – sie ist ein ergänzender, epistemologisch kohärenterer Rahmen für Exercise Sciences.
Das grundlegende Problem: Der p-Wert beantwortet die Frage „Wie wahrscheinlich ist das Ergebnis, wenn bei einer Intervention die Nullhypothese widerlegt werden kann?" – Wichtig sein kann aber auch die Frage: „Wie wahrscheinlich ist der Effekt meiner Intervention für ein Individuum?" Das ist eine fundamental andere Frage. Nur Bayesianische Statistik beantwortet sie direkt. Diaz-Quijano et al. (2020) zeigen, dass selbst Wissenschaftler, die statistischer Signifikanz abschwören wollen, diese in der Praxis kaum vermeiden können – ein deutliches Zeichen dafür, dass es auch andere Zugehensweisen braucht.
Von Prior zu Posterior – der Bayesianische Kreislauf
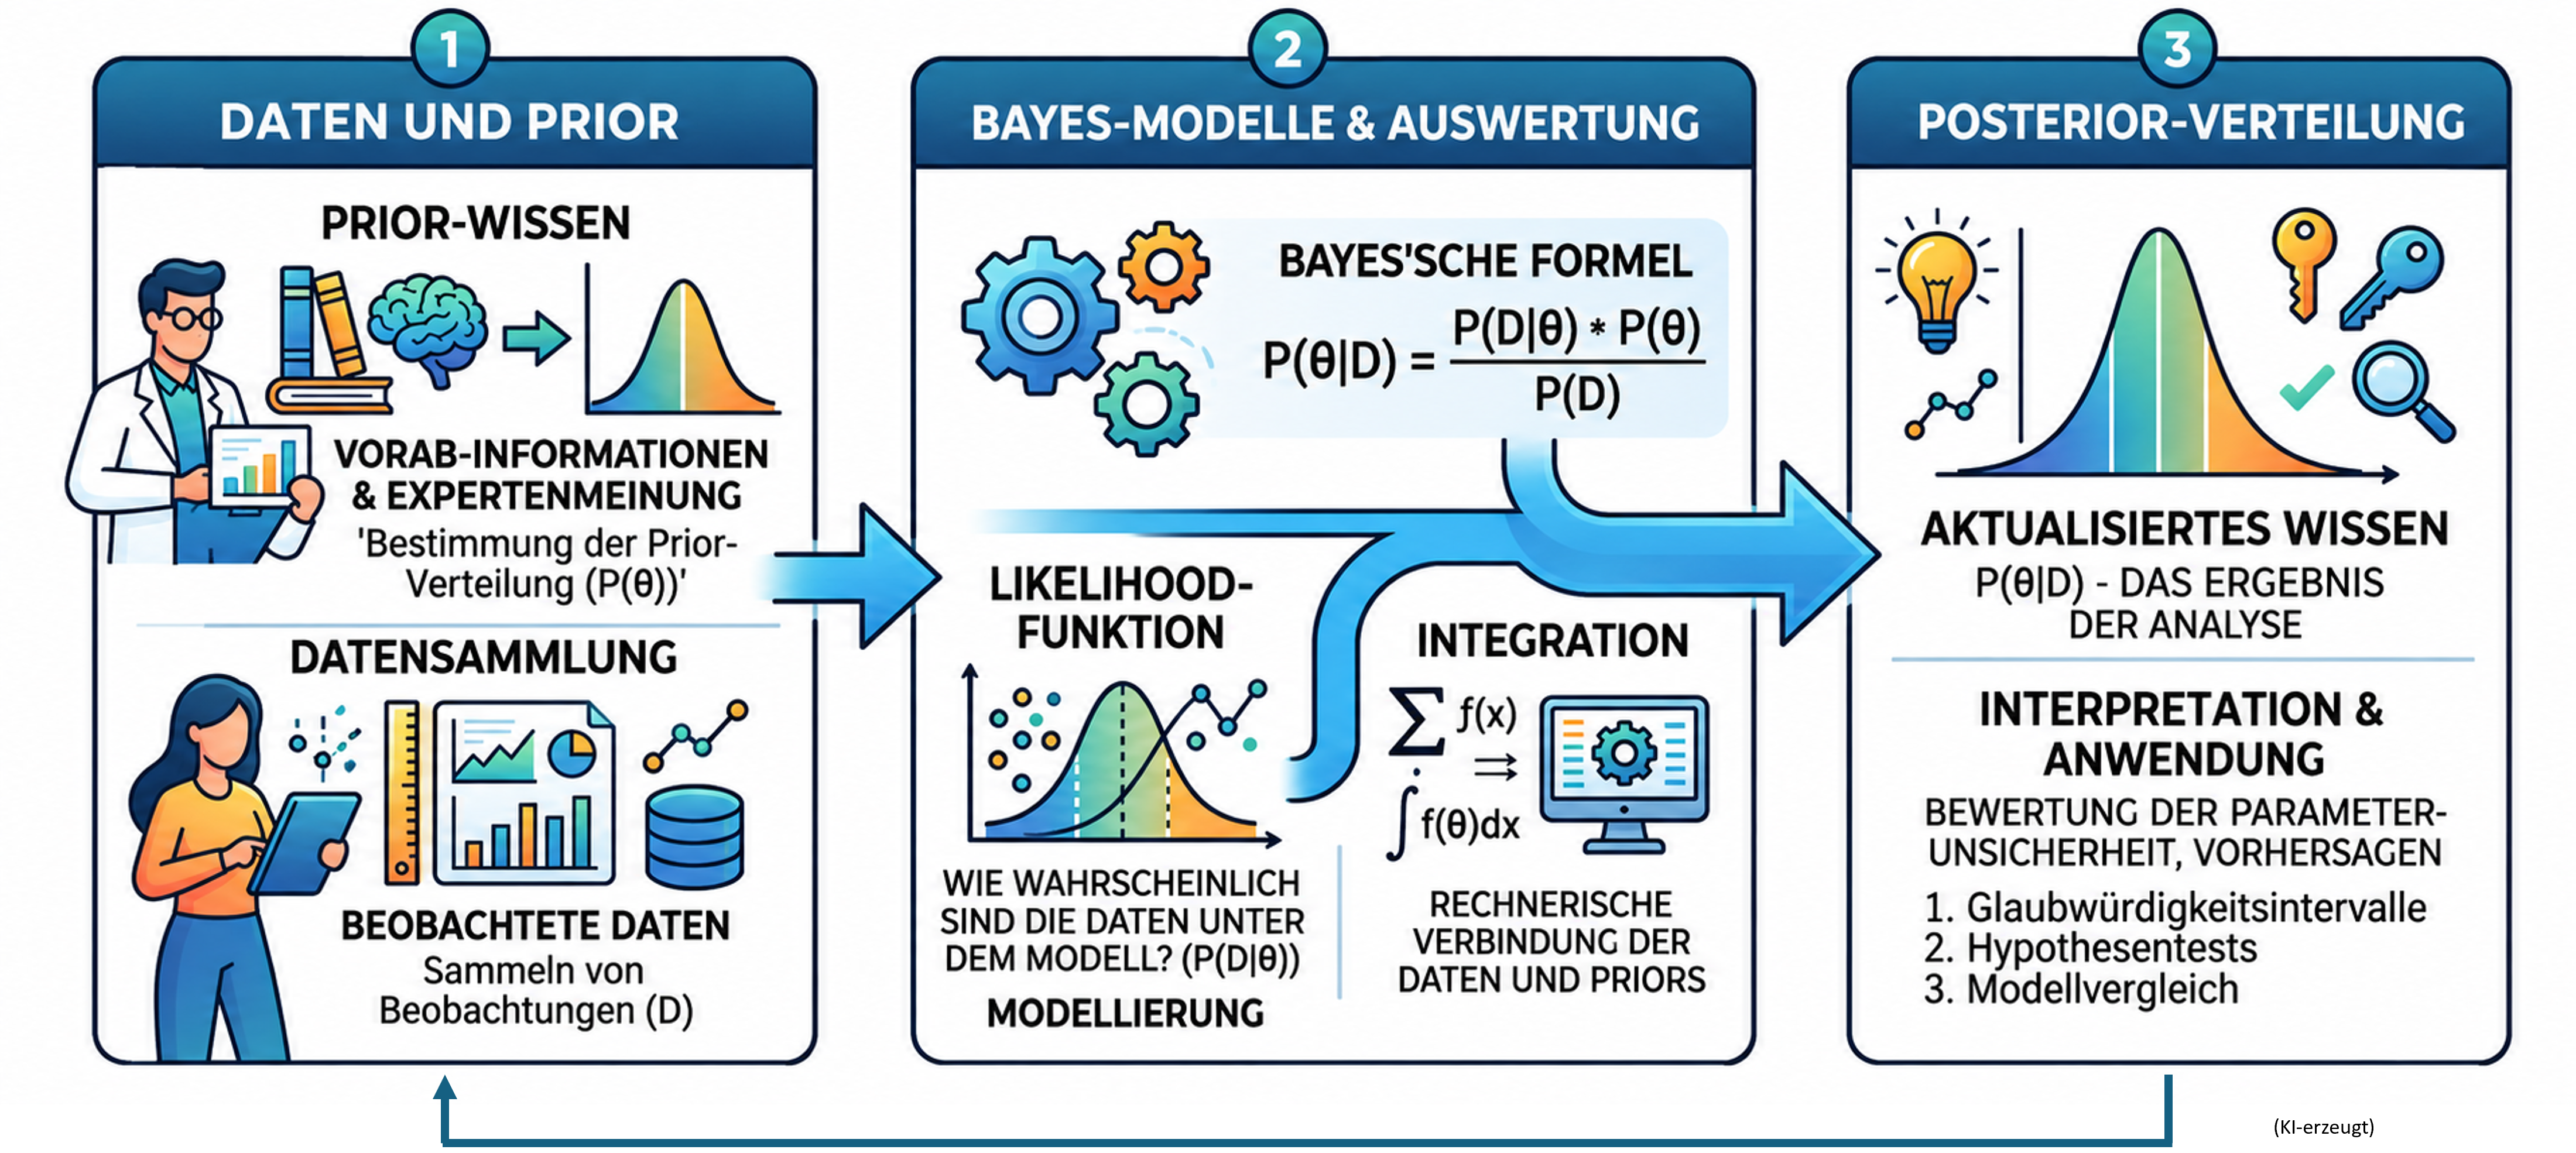
Drei Schritte fassen das Prinzip zusammen, das in den folgenden sechs Kapiteln vertieft wird: Zunächst wird Vorwissen als Prior-Verteilung formuliert und mit beobachteten Daten zusammengeführt. Die Bayes'sche Formel verbindet beides über die Likelihood-Funktion – wie wahrscheinlich sind die Daten unter einem bestimmten Modell? Das Ergebnis ist die Posterior-Verteilung: aktualisiertes Wissen, das direkt für Glaubwürdigkeitsintervalle, Hypothesentests und Modellvergleiche genutzt werden kann.
Sieben Bausteine, ein roter Faden
Vom Grundlagenvergleich über ein durchgerechnetes Praxisbeispiel bis zu interaktiven Rechnern, der Individualitäts-Frage, dem Bayes Factor und der Literaturbasis – jedes Thema ist eine eigene Seite.
Wie wir Bayes in RAES umsetzen: Jede Forschungssäule auf dieser Website präsentiert – wo verfügbar – sowohl frequentistische als auch bayesianische Analysen im direkten Vergleich. Priors werden explizit begründet. Bayes Factors und Posteriori-Verteilungen werden visualisiert. Das Ziel: transparente, kumulative und praxisrelevante Wissenschaft.